

W poprzednich lekcjach omawialiśmy zbiory (Set) w Javie, które usuwały duplikaty i porządkowały dane według zasady unikalności. W praktyce szybko pojawia się kolejny problem. Dane przestają być jednorodną listą elementów i zaczynają mieć swoje identyfikatory. Kolekcje i listy w Javie nie wystarczają, gdy potrzebujemy powiązać jeden element z drugim w relacji. Tutaj wprowadzamy mapy, które drastycznie zmieniają sposób myślenia o danych, ponieważ zamiast pojedynczych wartości pracujemy na parach klucz – wartość. To fundamentalna zmiana. Nie przeszukujemy już całej struktury, żeby znaleźć dane. Przechodzimy bezpośrednio po kluczu i otrzymujemy konkretną wartość.
Wykorzystujemy te struktury wszędzie tam, gdzie szybki dostęp do danych ma znaczenie dla działania programu.
Wprowadzenie
Wyobrażamy sobie bibliotekę. Każda książka ma swój numer katalogowy. Nie szukamy jej między półkami losowo. Idziemy po numerze, a system wskazuje dokładne miejsce. Numer katalogowy pełni rolę klucza, a książka jest wartością. Tak działają Mapy w Javie. Kolekcje i listy w Javie opierają się na sekwencji, natomiast Mapy wprowadzają bezpośrednie powiązanie danych. Klucz prowadzi nas dokładnie tam, gdzie znajdują się informacje. W tym modelu nie interesuje nas kolejność elementów, tylko relacja między nimi.
Chociaż mapy stanowią integralną część Java Collections Framework, to ich struktura różni się od list czy zbiorów. Mapy nie implementują interfejsu Collection, ponieważ nie przechowują pojedynczych elementów, lecz pary powiązanych ze sobą obiektów. Wykorzystujemy te struktury wszędzie tam, gdzie czas odnalezienia danych decyduje o stabilności i szybkości całego programu.
Mapy
Mapy nie są rozszerzeniem List ani zbiorów Set. To osobna struktura, która działa w oparciu o pary klucz -wartość. Mapy są użyteczne wtedy, gdy przestajemy myśleć w kategoriach listy elementów, a zaczynamy pracować na relacjach. Każdy element dostaje swój identyfikator, czyli klucz, który prowadzi bezpośrednio do wartości. Nie iterujemy ciemno po danych, a wskazujemy konkretny punkt i system zwraca wynik. Mapy nie przechowują elementów liniowo jak Listy, nie pilnują też unikalności jak zbiory. Ich rolą jest szybkie mapowanie: klucz – wartość.
Rodzaje implementacji
Implementujemy różne wersje tego interfejsu w zależności od tego, czy zależy nam na maksymalnej szybkości, czy na zachowaniu konkretnej kolejności danych.
HashMap
Najczęściej wybieraną implementacją Mapy w Javie jest HashMap. Jej działanie opiera się na mechanizmie tablicy mieszającej (hashing), dzięki czemu system bardzo szybko odnajduje powiązanie między kluczem, a wartością. W praktyce czas odczytu wartości pozostaje bardzo szybki i nie zmienia się odczuwalnie wraz ze wzrostem liczby danych. Nie ma znaczenia, czy przechowujemy kilka wpisów, czy miliony rekordów, ponieważ Java nie musi przeglądać całej struktury. Każdy klucz trafia do konkretnego miejsca na podstawie wartości wygenerowanej przez kod mieszający, co pozwala systemowi natychmiast wyciągnąć przypisaną do niego wartość.
HashMap wybieramy wtedy, gdy liczy się wydajność i szybki dostęp do danych. W zamian tracimy kontrolę nad kolejnością. Elementy mogą być zwracane w różnej kolejności i nie możemy na tym opierać logiki programu.
Przykład:
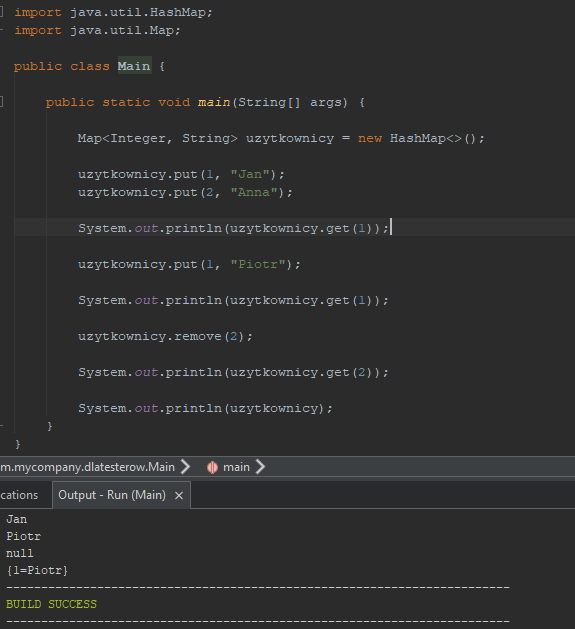
Na początku implementujemy mapę Map<Integer, String> jako HashMap, która przechowuje identyfikatory użytkowników jako klucze oraz ich imiona jako wartości. Ta struktura nie utrzymuje żadnej kolejności danych, skupia się wyłącznie na szybkim dostępie do wartości po kluczu. Dodajemy elementy metodą put() w dowolnej kolejności. Następnie pobieramy wartość dla klucza 1 za pomocą get(1), co zwraca aktualnie przypisane imię. Kolejny krok to nadpisanie tego samego klucza przez put(1, "Piotr"), co zastępuje poprzedni wpis. Ponowne użycie get(1) pokazuje już nową wartość. Usunięcie elementu metodą remove(2) całkowicie usuwa wpis z mapy, a kolejne odwołanie do tego klucza zwraca null. Na końcu wypisujemy mapę, gdzie widzimy brak gwarantowanej kolejności elementów.
TreeMap
Drugą często używaną implementacją Mapy jest TreeMap. W przeciwieństwie do HashMap nie korzysta z tablicy mieszającej, tylko z uporządkowanej struktury drzewa. Oznacza to, że wszystkie elementy są zawsze posortowane według klucza. Każdy dodany klucz system natychmiast porównuje z innymi w odpowiedniej gałęzi struktury drzewiastej. Niestety wiąże się to z zmniejszeniem szybkości działania. Odnalezienie elementu trwa nieco dłużej, ponieważ Java musi przejść przez poszczególne poziomy drzewa, aby dotrzeć do szukanej wartości.
TreeMap wybieramy wtedy, gdy zależy nam na uporządkowanych danych, gdy chcemy uniknąć ręcznego sortowania danych po ich pobraniu.
Przykład:
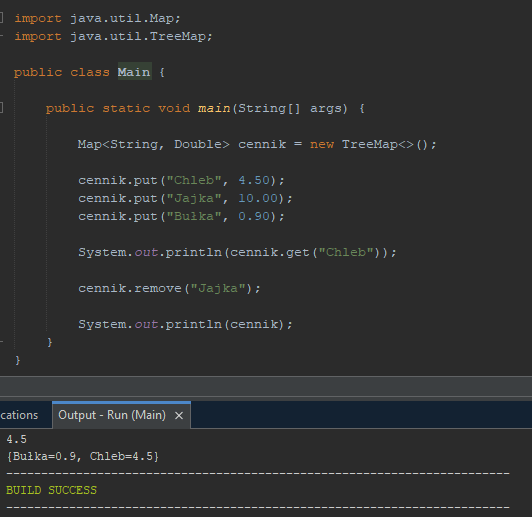
Na początku implementujemy mapę Map<String, Double> jako TreeMap, która przechowuje nazwy produktów jako klucze oraz ich ceny jako wartości. Struktura automatycznie sortuje dane po kluczach i utrzymuje porządek alfabetyczny. Dodajemy elementy takie jak „Chleb”, „Jajka” oraz „Bułka” metodą put() w losowej kolejności, ale mapa sama ustawia je zgodnie z porządkiem alfabetycznym kluczy. Następnie pobieramy cenę przez get("Chleb"), co pozwala na szybki odczyt przypisanej wartości. Usuwamy element metodą remove("Jajka"), co całkowicie usuwa wpis z mapy. Każde kolejne zapytanie o ten klucz zwróci null. Na końcu wypisujemy całą zawartość mapy, gdzie widzimy dane automatycznie uporządkowane według kluczy.
Operacje CRUD na mapach
Praca z mapami w Javie opiera się na prostym schemacie operacji na danych, który różni się od tego, co znamy z list. Mapy przechowują dane w formie par klucz – wartość, gdzie każdy klucz jest unikalny i wskazuje dokładnie jedną wartość.
Dodanie nowych danych realizujemy przez metodę put(), która zapisuje nową parę. Jeśli użyjemy klucza, który już istnieje w mapie, system automatycznie nadpisze starą wartość nową, co w naturalny sposób realizuje operację aktualizacji. Odczyt wykonujemy przez get(), które zwraca wartość przypisaną do klucza. Jeśli klucz nie istnieje, system zwraca null. Usunięcie realizujemy przez remove(), które całkowicie usuwa wpis z mapy.
W mapach nie operujemy na indeksach. Klucz zastępuje pozycję i staje się jedynym punktem dostępu do danych.
Iteracje
Mapy nie działają jak Listy czy Sety, ponieważ nie operujemy tutaj na indeksach, ani pojedynczych elementach. Każdy wpis to para klucz – wartość, więc iteracja musi uwzględniać oba elementy jednocześnie.
Pętla for-each (entrySet)
Najprostszy i najczęściej używany sposób przechodzenia po Mapie, ponieważ daje dostęp jednocześnie do klucza i wartości.
Przykład:
for (Map.Entry<Integer, String> wpis : osoby.entrySet()) {
    System.out.println("ID: " + wpis.getKey() + " | Imie: " + wpis.getValue());
}
W tym podejściu entrySet() zwraca wszystkie wpisy mapy jako zestaw par klucz – wartość. Każdy element to obiekt Map.Entry, który trzyma oba elementy razem. Dzięki temu nie musimy wykonuwać dodatkowych operacji, żeby dostać się do danych, wszystko jest w jednym kroku. Pętla przechodzi przez każdy wpis, a my odczytujemy klucz przez getKey() i wartość przez getValue(). Każdy element zostaje przetworzony jeden po drugim aż do końca mapy.
Ten wariant wybieramy wtedy, gdy pracujemy na pełnych danych i potrzebujemy zarówno klucza jak i wartości.
Iteracja po kluczach (keySet)
Stosujemy, gdy interesują nas tylko klucze, a wartości pobieramy osobno.
Przykład:
for (Integer id : osoby.keySet()) {
    System.out.println(id + " | " + osoby.get(id));
}
keySet() zwraca zbiór wszystkich kluczy z mapy. Iterujemy tylko po nich, a wartości pobieramy dodatkowym wywołaniem get().
Ten wariant ma sens wtedy, gdy operujemy głównie na identyfikatorach i nie potrzebujemy bezpośrednio całych par danych.
Iteracja po wartościach (values)
Stosujemy, gdy interesują nas tylko wartości bez kluczy.
Przykład:
for (String imie : osoby.values()) {
    System.out.println(imie);
}
values() zwraca samą kolekcję wartości z mapy. Klucze są całkowicie pomijane, a my pracujemy wyłącznie na danych.
Ten wariant używamy wtedy, gdy relacja klucz–wartość nie ma znaczenia, a liczy się sama treść.
Pętla for
Pętla for nie ma zastosowania, ponieważ Mapy nie udostępniają indeksów liczbowych. Nie możemy pobrać elementu poprzez podanie jego kolejności, tak jak robimy to w tablicach, ponieważ klucze w mapie zastępują pozycję i stanowią jedyny sposób dostępu do danych.
Iterator
Iterator stosujemy wtedy, gdy chcemy bezpiecznie usuwać elementy podczas iteracji. To jedyny bezpieczny sposób modyfikacji mapy w trakcie przechodzenia po niej.
Przykład:
Iterator<Map.Entry<Integer, String>> it = osoby.entrySet().iterator();

while (it.hasNext()) {
    Map.Entry<Integer, String> wpis = it.next();

    if (wpis.getValue().equals("Anna")) {
        it.remove();
    }
}
Iterator przechodzi po mapie element po elemencie. Metoda next() zwraca aktualny wpis, a remove() usuwa go bezpośrednio ze struktury. Dzięki temu nie dochodzi do błędów modyfikacji podczas iteracji i zachowana zostaje spójność danych.
Podsumowanie
Mapy w Javie zmieniają sposób pracy z danymi, ponieważ odchodzimy od myślenia w kategoriach listy elementów i przechodzimy na model relacji klucz – wartość. Zamiast przeszukiwać całą strukturę, trafiamy bezpośrednio do konkretnej informacji przez klucz.
HashMap daje maksymalnie szybki dostęp do danych, ale nie gwarantuje kolejności. TreeMap wprowadza porządek według kluczy, kosztem nieco wolniejszego dostępu. W obu przypadkach mechanika pozostaje ta sama: klucz wskazuje dokładnie jedną wartość.
Iteracje pokazują, że Mapy nie działają jak Listy czy Sety. Nie używamy indeksów, tylko pracujemy na entrySet, keySet lub values, w zależności od tego, jaki widok danych jest potrzebny.
W kolejnym kroku przechodzimy do struktur liniowych, które nie opierają się ani na relacjach klucz–wartość, ani na unikalności czy indeksach, tylko na kolejności operacji wykonywanych na danych.
O autorze
Tester oprogramowania z pasją do jakości i technologii. Łączy doświadczenie w testach manualnych i automatycznych, koncentrując się przede wszystkim na aplikacjach webowych oraz usługach SOAP i REST. Testowanie to dla niego nie tylko szukanie błędów, ale przede wszystkim kwestionowanie przyjętych założeń i usprawnianie tego, co nie działa – również w samym procesie testowym. Lubi zmieniać, angażować się i aktywnie budować proces testowy, tak by miał sens, a nie tylko formę. Prywatnie fan rocka, biwakowania, podróży.


